Need4more
V2EX  ›  Local LLM

mac 本地部署 llm 不是最佳选择

  •  
  •   Need4more · Aug 31 · 8310 views

    有人说 AI 时代苹果是最大赢家,核心在于 mac 的成本优势,我不赞成。

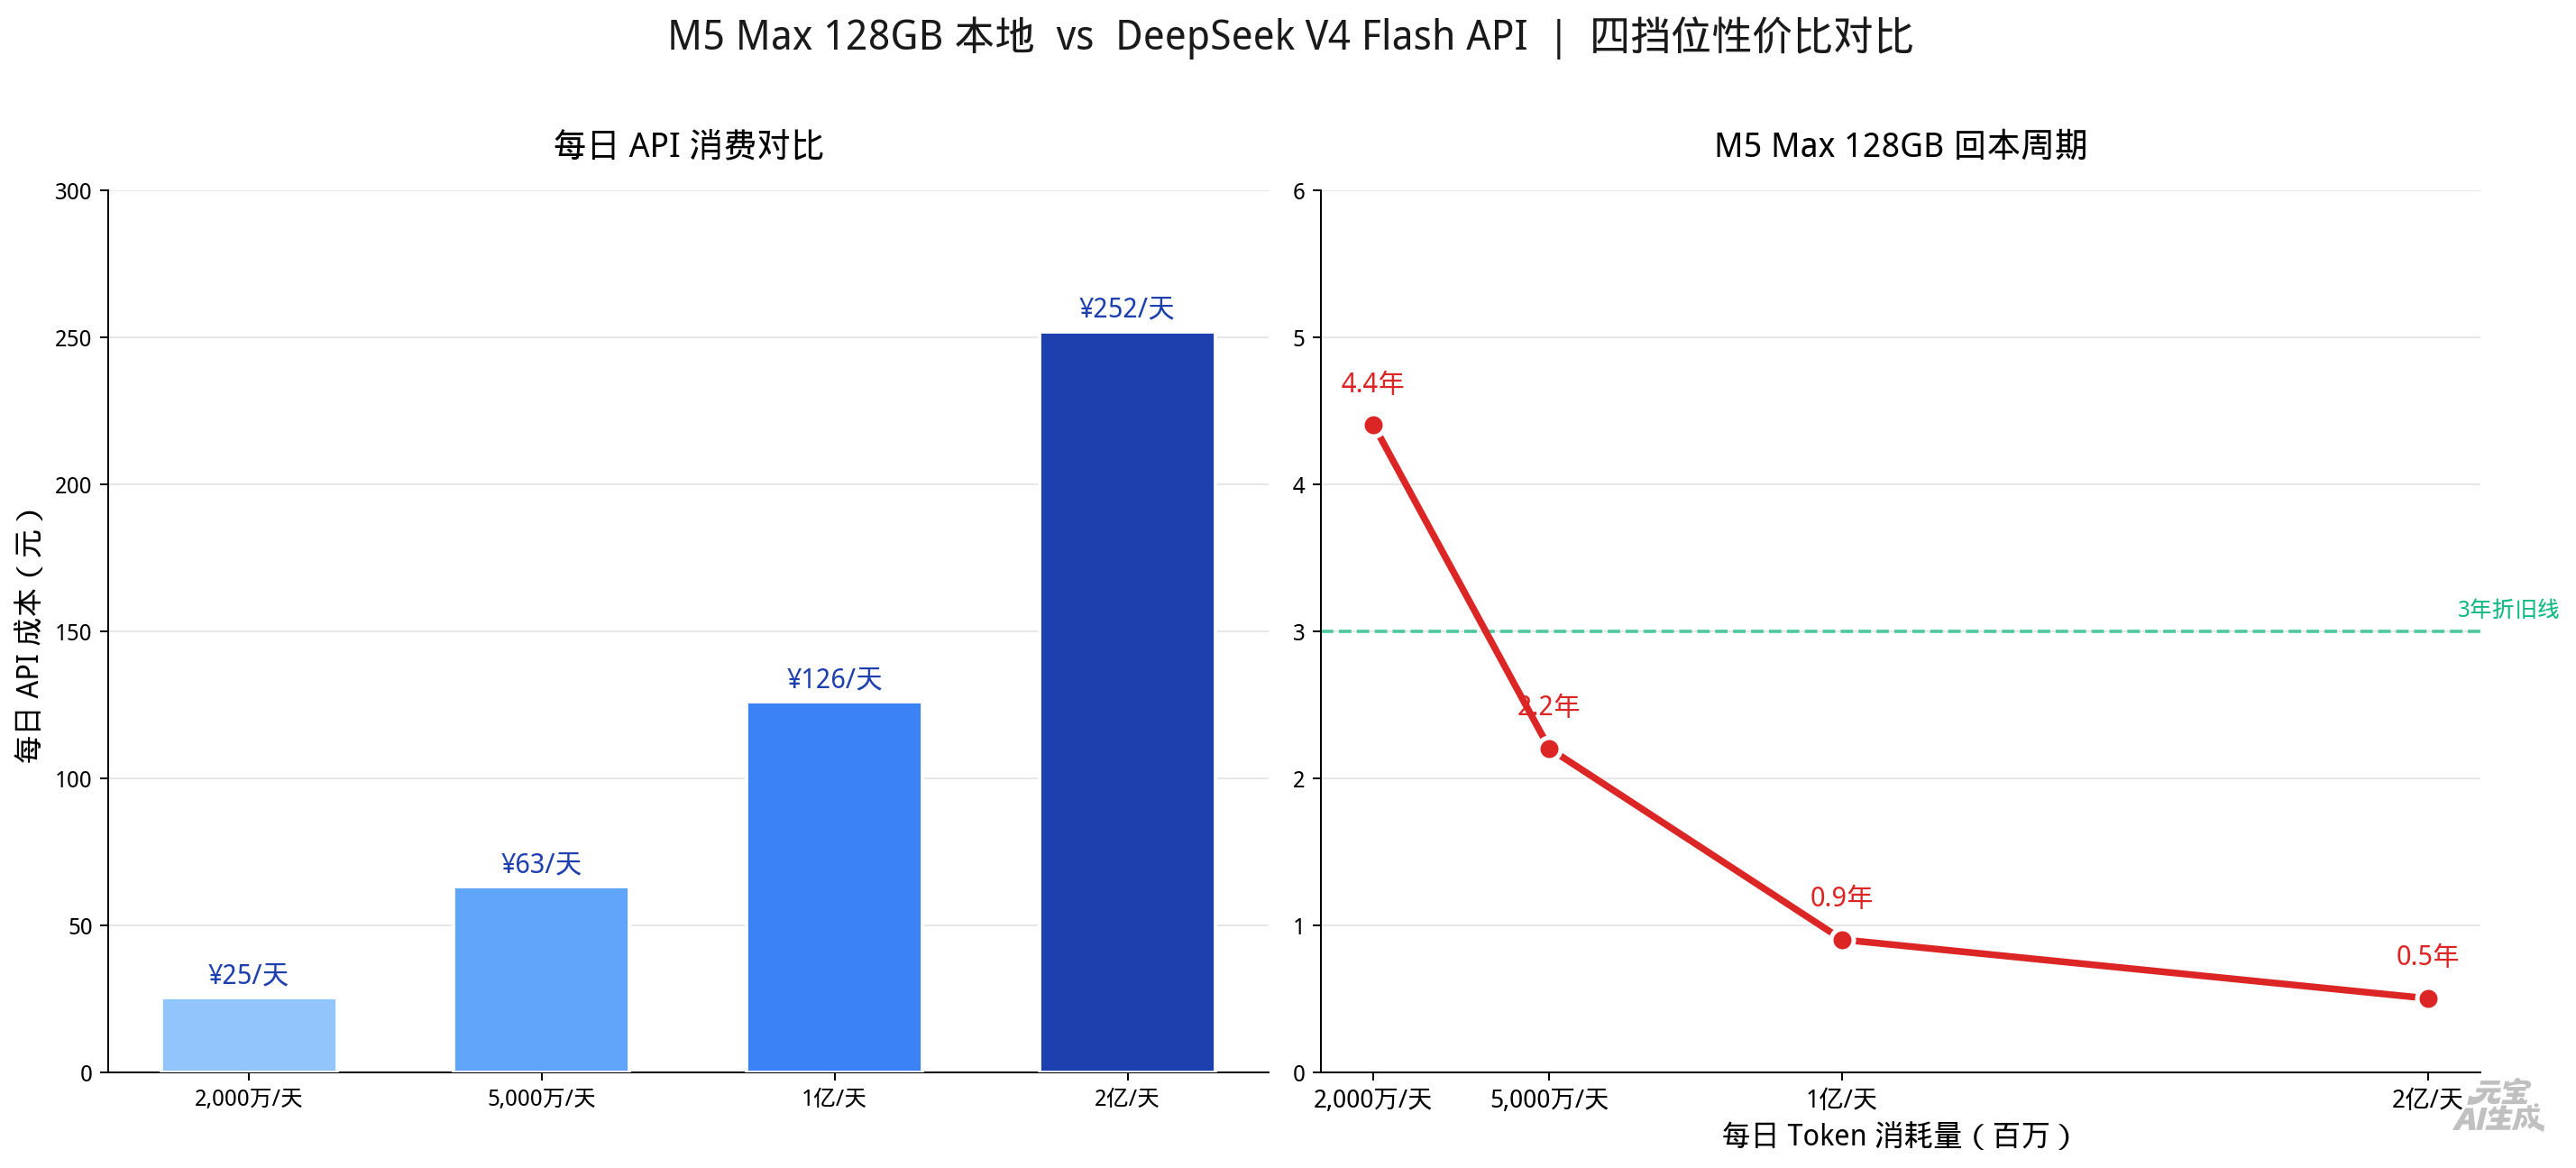
    在成本方面,按照我个人的使用经验,调用云端 api (我们假设使用的是 deepseek v4 flash)每日成本在¥25/天,如果购买 M5 Max 128GB (市场价 4w )的话,回本周期为 4.4 年,超过电子产品的 3 年折旧期。

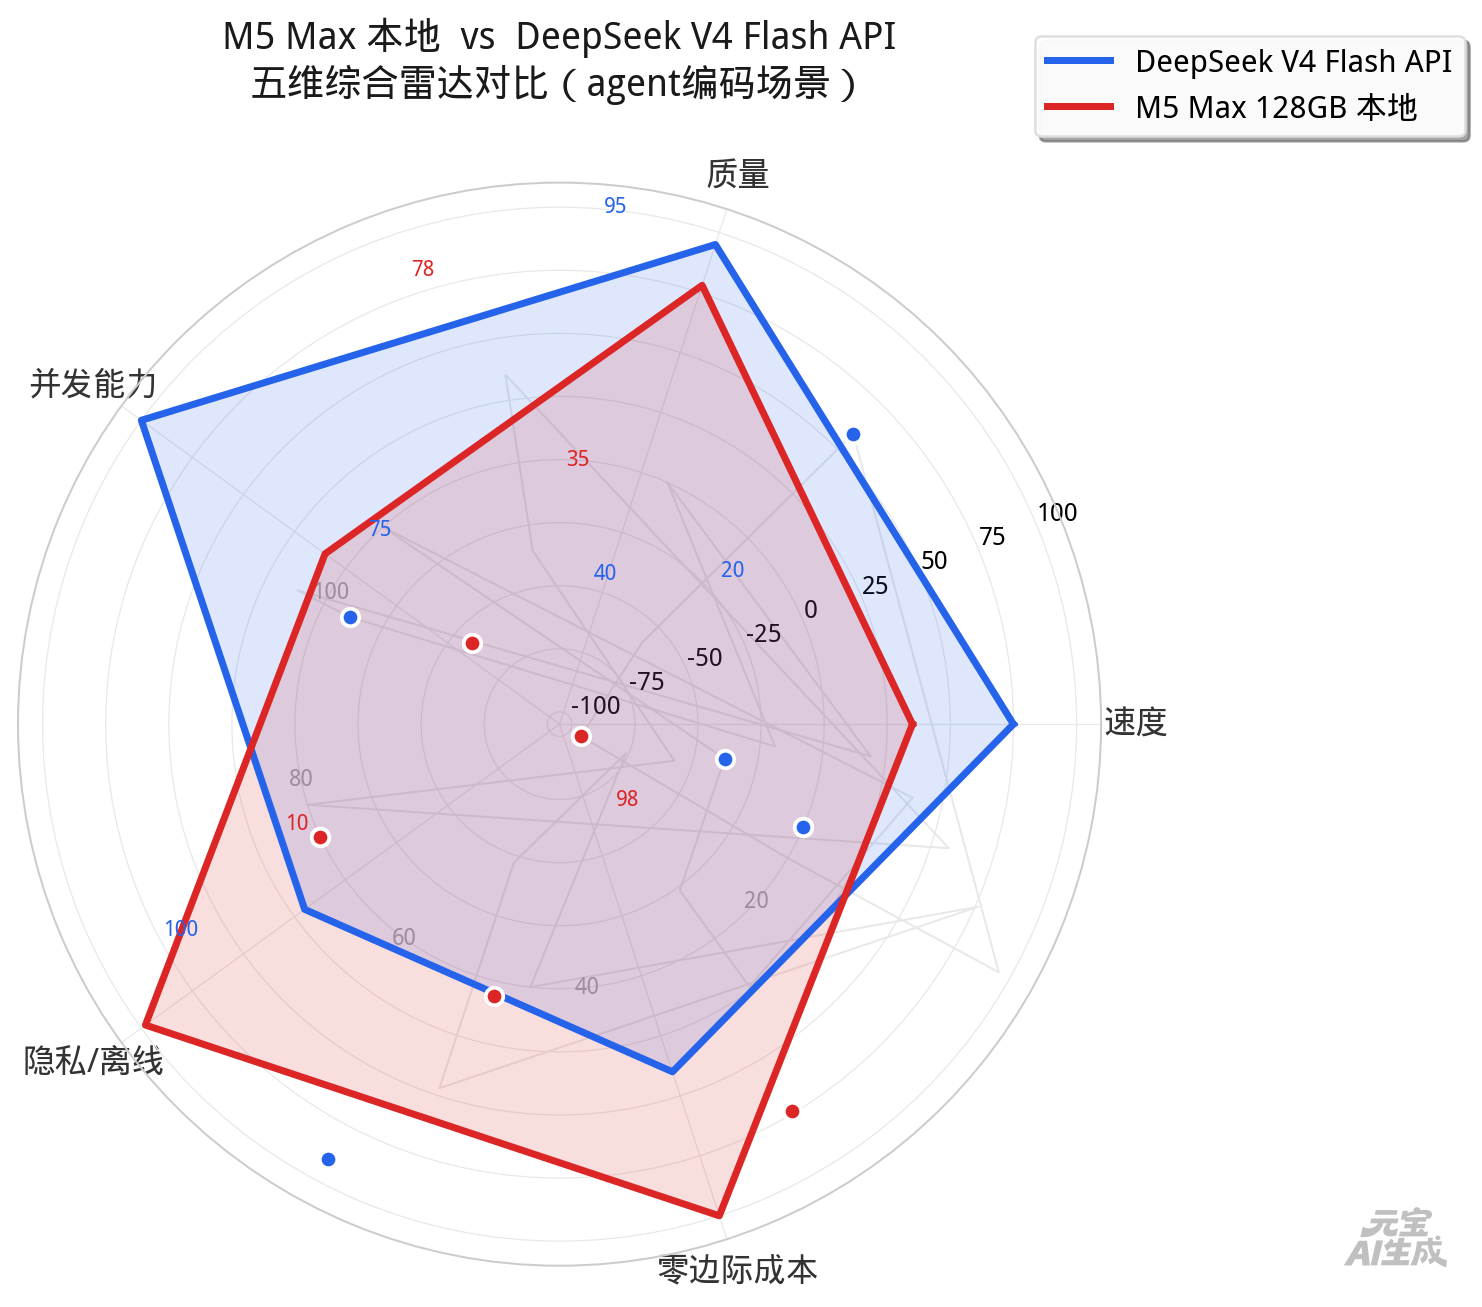
    抛开价格,我更在意速度和质量,日常使用体验直接和这两个挂钩,这块 api 明显占优,本地大模型量化后慢吞吞的、质量差要返工。唯一的优势就是隐私了,但是个人使用不在意这个。

    毫无悬念,最佳选择是用 API ,买机器是负投资。

    90 replies    2026-09-08 16:46:44 +08:00
    sentinelK
        1
    sentinelK  
       Aug 31   ❤️ 3
    其实这个逻辑很简单。
    如果只算经济账,自部署 LLM 性价比就能超过云厂商,那云厂商为何不用这款设备?

    自部署本质上就是一种反效率的个性化需求。即便如今 sglang 把 Qwen3.8-27B 的 prefill 性能和缓存巡回概率拉高到了和 API 接近的程度,且 flash-0731 涨价 5~6 倍的前提下,如果只算经济账,依然是不划算的。

    如果按照回本率来看,目前 5 系 N 卡+SGLang+Qwen3.8-27B 这套组合,应该是最接近同模型云厂商的。
    不光是 SGLang 的优化够强,还包含 Qwen3.8-27B 的云服务价格够贵。
    lynn1su
        2
    lynn1su  
       Aug 31
    mac 没法做到 1m 上下文把? api 是可以的
    Need4more
        3
    Need4more  
    OP
       Aug 31
    @lynn1su 我说了,在速度和质量这块,本地大模型零优势
    aimuz
        4
    aimuz  
       Aug 31
    M5 Max 128GB 能部署 flash-0731 满血版吗
    aimuz
        5
    aimuz  
       Aug 31
    M5 Max 128GB 五年后残值还能值 1 万 吧
    Need4more
        6
    Need4more  
    OP
       Aug 31
    @aimuz 明显不能,这个配置只能跑一些量化版本的,刚入门,不是最顶级的
    kevan
        7
    kevan  
       Aug 31
    如果只算经济账,自部署 LLM 性价比就能超过云厂商,那云厂商为何不用这款设备?

    +1, 卖的没有买的精吗?
    x1aoYao
        8
    x1aoYao  
       Aug 31
    你只考虑经济,不考虑审查/保密这些特殊需求,那确实没必要本地部署
    lesismal
        9
    lesismal  
       Aug 31
    1. 99%自部署的人都懂 OP 说的
    2. OP 不知道自部署的人的需求
    sagnitude
        10
    sagnitude  
       Aug 31   ❤️ 5
    @lesismal 事实上 99%集中发 mac 可以部署本地模型 的推荐和介绍帖子都不会提保密之类的真实需求,都会加上“买了就 token 自由”这种说明
    lesismal
        11
    lesismal  
       Aug 31
    @sagnitude 价格本身就是一道拦路虎,买之前没几个不计算、对比清楚的,这种简单的计算和对比对于要搞本地部署的人来讲根本没什么难度。

    只有极少的人不懂却买了,比如一些小老板,跟着概念炒作就来劲,并且这点钱对于老板来讲也不多,就当玩也不觉得亏。
    ahdw
        12
    ahdw  
       Aug 31   ❤️ 6
    这么算账的话,你买车的养车用车的钱,够你打车打一辈子。
    那为什么会有私家车市场?而且还不断普及、下沉?

    显然你少算了。
    sn0wdr1am
        13
    sn0wdr1am  
       Aug 31   ❤️ 1
    本地部署考虑的是安全,隐私,而不是经济性。
    ffalex
        14
    ffalex  
       Aug 31 via Android
    本地部署首先追求的也不是省钱吧?你让 claude 生成张色图,人家也不干啊
    l1ve
        15
    l1ve  
       Aug 31
    你拿一个本身不是为了 AI 设计的产品去跑 AI ,然后说不是最佳选择?

    自建算力对外出售价是可以做到官方价格的 5-7 折,70%利用率下一年回本不是玩笑。

    你这就好比买了个玩具挖掘机,然后说这东西不是做工程的最佳选择
    shyrock2026
        16
    shyrock2026  
       Aug 31
    都算经济账了,没有考虑一下智能硬件在持续涨价?
    june4
        17
    june4  
       Aug 31
    @shyrock2026 把硬件持续涨价当常态了,看看以前内存是什么价,也就是这波 ai 突起产能跟不上,几年后可能又是一地鸡毛
    Frankcox
        18
    Frankcox  
       Aug 31
    你把两个问题混杂了。你说的成本问题是云端 vs 本地,而不是 mac 跑 AI 是否是最佳选择(相比于 Linux/Windows + Nvidia 显卡)。


    第一个问题算是日常问题了,你要只看经济成本云端自然有优势,但是本地模型配合 huggingface 的各种 jailbreak 破限,能提供完全无审核的内容,R-18,R-18G,极端内容等等。这对一些人来说就是刚需,更不用提其他对隐私安全有要求的企业人员。
    另外,很多任务并不需要很大很强的模型,不是所有人都要用 AI 作为 code agent 跑一堆高难任务超大上下文。我现在做文生图的 prompt 扩写,图像反推等都是用 qwen3.5-9B 的模型就能跑,效果还很不错。

    第二个问题,mac 称为本地 LLM 的最佳选择是因为 UMA 统一内存架构,Mac 内存价格是金子,那 Nvidia 显存的价格则是振金,而本地跑 LLM 的一个很大问题就是能不能把模型全塞到显存里。所以这么一看 Mac 相比于买显卡拼集群,反而是一个比较有性价比的选择。
    Need4more
        19
    Need4more  
    OP
       Aug 31
    @Frankcox 你的回答很有水平。你说的这些需求当然存在,但我说的是日常干活的情况下(大部分应该都是这么用的吧),考虑性价比和使用体验,mac 本地部署不是个好选择
    qiuhang
        20
    qiuhang  
       Aug 31
    个人正常用自部署包亏的,很多自部署的往往是用来搞些商业模型不让做的事。比如搞色情内容之类的。
    EdwardKot
        21
    EdwardKot  
       Aug 31 via iPhone
    标题没问题,但是你正文里不在乎的东西可能恰好是别人最在乎的的东西,本地部署 LLM 和 api 的区别,花了钱的人并且买了机器本地部署的用一下就有很明显的体感区别,不是必要的话没人想花了大价钱再捏着鼻子用
    phrack
        22
    phrack  
       Aug 31
    > 唯一的优势就是隐私了,但是个人使用不在意这个。

    不是哥们,个人使用最在意这个,你是正常人吗

    再说,我本来就需要电脑,能跑 llm 只是附带的价值
    Joyflare
        23
    Joyflare  
       Aug 31
    API 适合干正事,本地模型适合干‘不能给别人看’的事。你跟官方 API 提那些限制级的要求试试?能跑起来就挺好了,要啥自行车啊。
    sillydaddy
        24
    sillydaddy  
       Aug 31 via Android
    回本要分使用情景的,跑满负载肯定是可以一年左右回本的。你要非用 1M 上下文,全速输出这种,那肯定回不了,因为机器的限制就在那。但是你的使用情景如果能跑满负载,忍受对话速度稍慢些,上下文小些,那肯定可以很快回本。

    另外大厂不部署,并不能说明不能回本。最简单的例子,1 立方米仓库可以容纳的计算密度,可能就完全把这个排除了!何况还有前面提到的每个人使用情景都不相同,大厂部署根本没有个人灵活。

    楼主拿自己每天花费 25 元来说不能回本,完全是站不住脚的。
    Need4more
        25
    Need4more  
    OP
       Aug 31 via iPhone
    @EdwardKot 欢迎你分享本地部署的使用体验,而不是盲从别人
    Need4more
        26
    Need4more  
    OP
       Aug 31
    @phrack 别人身攻击,这样显得你很没素质。
    jetsung
        27
    jetsung  
       Aug 31
    自己部署的,可不止 DeepSeek 的模型,可以部署各种模型。所以没有可比性。
    Gomoku2024
        28
    Gomoku2024  
       Aug 31   ❤️ 1
    首先,电脑不只是能跑 AI ,同样不耽误用来做其它工作,不要用其价格来与线上 api 相比,因为就算有 api 你大概率也是需要一台电脑,配置也不会很低;其次,本地无限跑,可以试多种模型,这是 api 无法体会到的自由;然后,隐私和安全,可以不用在意 AI 知道你的关键资料和信息,这也是一种难得的自由;再次,在线 api 天然有各种限制,而开源破解模型束缚就要小很多,可以教你造 he 弹,出 H 图,这也是需求。最后,128G 内存的 Mac ,五年后肯定能到一万的残值。
    phrack
        29
    phrack  
       Aug 31
    @Need4more 不是哥们你怎么给我扣帽子

    我说了个人都关心自己的隐私,你说个人不关心隐私,我不得问问你是正常人不?

    你以为的正常人是什么意思?
    Frankcox
        30
    Frankcox  
       Aug 31 via Android
    @Need4more 我知道一个做文生图 lora 训练框架的开发者,因为打标 prompt 涉及萝莉等词语,开发过程中直接被 codex 封号,申诉也无效,这就是云端的问题。

    另外,如果你完全不考虑隐私安全敏感内容,只考虑性价比和能力,那肯定是云端强啊,fable 5 ,gpt-5.6 这些顶尖模型压根就不开源,你哪怕弄了个 1T 内存的 mac 也只能跑次等的 deepseek glm 等量化后的模型。

    所以这个问题本来就算不上问题,买 mac 跑本地模型的人压根就不会用到需要 fable 5 ,gpt-5.6 sol 极高,性能的模型,人家就是跑一些低等模型,你可以多去 reddit localllm 等逛逛,你就知道 qwen 3.8 27B 这种体量的模型已经是最受欢迎的了。deepseek 这种大型的模型都没几个人步数。

    最后,你可能低估了小尺寸模型的能力(我 4070 一直跑 qwen3.6 35B a3b ,这个模型已经能满足我日常 70 %的任务),严重低估了人们对无审核模型的需求(我知道几个搞 ai 色 q 的已经财富自由了)
    Need4more
        31
    Need4more  
    OP
       Aug 31
    @phrack 我没有要说服你的意思。但你要是现实里这样的态度和人交流,是会被打的。
    xing7673
        32
    xing7673  
       Aug 31
    比起经济性、隐私性,最主要的还是可用性
    ds v4 这种顶级 infra 在高峰期也有不可用的时候,对于 24 小时服务来说是完全不可接受的
    mac 跑 llm ,其他还有的优势是:
    物理:静音、功耗低(散热压力小,硬件损管工程要求低)、体积小、接口丰富有扩展性(甚至有逆向 lightning 接 pcie 的项目)、不亚于 4090 的内存速率
    逻辑:mac 系统、除 cuda 外的第二大模型运行生态 mlx 和活跃开源客户端 omlx

    综上:mac m5u 256 订单延后到 12 月不是没有原因的
    Need4more
        33
    Need4more  
    OP
       Aug 31 via iPhone
    @xing7673 这个就和坚信那些买房是刚需的人一样,想买总能找到一百个理由说服自己。希望你能分享自己使用 MAC 跑本地模型的真实体验,直接打我脸。
    Need4more
        34
    Need4more  
    OP
       Aug 31 via iPhone
    @Frankcox 你说的这些都对。我发帖的初衷是想说本地部署没有性价比和劣化的使用体验。考虑到 MAC 设备售价并不便宜,如果出于省钱目的消费的话,可能会让你失望。其他个性化需求当然存在,也很有价值,感谢你提供的信息。
    xing7673
        35
    xing7673  
       Aug 31
    @Need4more #33 我现在 24 小时跑新闻爬虫+本地模型工作流,不然我为啥说这个可用性问题。
    当然我选的是 48g 内存版本,比我有钱有预算的选 256g 更无可厚非。
    红迪里用 mac 玩 llm 的和用多卡级联的人数占比都差不多,玩 localllm 就是看自己需求,我机器想放在我床边,那不可能用任何带物理风扇的机器
    coefu
        36
    coefu  
       Aug 31
    本地用来搞算法创新,idea 验证,讲真我不会希望我的 idea 被云厂商知道,并拿去训练新的模型。

    可能是买 api 做的事,没什么卵价值,厂商都看不来,不屑于用来训练它们的模型,搞不好还污染他们的原始训练数据。😂
    EdwardKot
        37
    EdwardKot  
       Aug 31
    @Need4more #25 我有啥需要盲从别人的?我做的工作签了保密协议,我不知道 api 会不会泄露的情况下当然是我自己的本地 LLM 协助。你这人有点意思,你觉得你用不上,别人都是骗自己上的?然后呢?证明你是对的,我即世界?
    wwhc
        38
    wwhc  
       Aug 31
    云 API 的一个致命问题是稳定性及可靠性无法保证,保不准什么时候就降智了,根据这个 API 之前智力水准订制的产品的产出将可能出现不可预知的变化;或者如果企业订购的某一个 API 因为厂商模型升级而废弃,企业根据这个 API 订制的产品将可能需要根据新 API 中的模型的不同特性而重构。本地部署完全没有这个问题
    slowgen
        39
    slowgen  
    PRO
       20 days ago
    你假设的数据让你得到了错误的结论,因为你假设的 token 处理量太低了,当然如果你每天就用那么多,那确实回本周期慢。

    我用 4 卡 RTX Pro 6000 跑 Qwen3.8 Flash Next NVFP4 ,现在一天最多是跑 54 亿 token(有峰谷,不均匀),还是因为 SM120 在新模型 Day 0 支持不给力,降级到了 marlin 的 backend 数据,要是用新内核估计处理能力还能提升 20%。

    结合 Deepseek Harness 一个/goal 开放式任务可以跑 20 小时以上,最近我做了 xterm.js 移植到 dart 和 CSharp 的测试,然后用 Flutter 和 Avalonia 复刻 tabby ,并且自我迭代优化,几乎是每小时跑 1 亿 token 输入,25 到 30 万的 token 输出,缓存命中率一般在 98%~99%。按照 Qwen 官方定价每小时大概消耗 12~13 元。

    现在我的 M2 Ultra 跑 Qwen3.8 Flash Next 的 4bit 量化,短的上下文时,prefill: 538.1 token/s, decode: 55.2 token/s ,长任务会衰减,假设这个数据在 M5 Ultra 上不衰减(因为增强了 AI 部分计算性能),根据 M5 Ultra 对比 M2 Ultra 的带宽差异计算,decode 的 token/s 大概在 80 ~ 100 ,prefill 速度估计可以 x10 ,这个意义在与有 KV Cache 的部分不用重复 prefill ,跑 Agent 新追加的上下文一般是并发读文件,追加的文件到上下文里几乎秒处理完,保守点的估计每小时 3000 万到 5000 万的 token 应该有,对比官方定价每小时消耗 6 元,一个月是 4320 元,M5 Ultra 256G 的 24 期免息分期费用每个月是 3615 元。
    shmilypeter
        40
    shmilypeter  
       20 days ago
    买 M5 Max 加上大内存大硬盘的,其实很多都是有剪辑工作流需求的用户,自媒体创作者之类的。

    如果只是纯开发,M5 Pro 加上 32G 以上的内存,加上无限 token plan 其实就够了。
    wangzr
        41
    wangzr  
       20 days ago
    只有你的需求是需求,别人的需求就不是?
    chemzqm
        42
    chemzqm  
       20 days ago
    deepseek v4 flash 用这玩意涨价前一天都得 20 多,现在翻倍都不止
    yjiefl
        43
    yjiefl  
       20 days ago via iPhone
    本地只能跑一些专门的小模型可能好些
    shyrock2026
        44
    shyrock2026  
       20 days ago
    @june4 #17 op 的分析就是以三年的折旧期为期限考虑的。这波硬件涨价潮持续三年的概率非常大。
    edisonwong
        45
    edisonwong  
       20 days ago   ❤️ 1
    我们二十台 dgx 自部署给研发用,各种调优,生产体验就是垃圾
    只是为了合规,离线,不泄露而已
    Topmax
        46
    Topmax  
       20 days ago   ❤️ 1
    自己部署除了吃配置屎还要吃优化屎,简直屎上加屎
    HENQIGUAI
        47
    HENQIGUAI  
       20 days ago
    这个逻辑非常奇怪,首先一个笔记本不是服务器,不是说除了玩模型就不能干任何事,就算是工作站、服务器也没规定只能一次做一件事吧,另外非得买最新最大内存的配置吗,M3Max 96G 行不行?直接便宜一半,体感还不一定有很大区别。最后,三年折旧期的算法是 3 年之后残值为零吗,如果这样的话到时候我出 500 块钱人民币购买楼主的 M5 Max 128GB 可以不,1000 也行
    isbase
        48
    isbase  
    PRO
       20 days ago
    @lesismal 除了大企业和政企机构。 普通公司和个人使用 ZDR Provider 相比本地部署有啥问题么
    homcrazy1
        49
    homcrazy1  
       20 days ago
    自己部署你想让他干嘛就干嘛
    elboble
        50
    elboble  
       20 days ago   ❤️ 1
    我个人经验是,速度凑合用,主要是上下文空间比不上云部署。

    P40 ,24G 的上古算力卡,Qwen3.8-27B-GGUF ,开了 mtp 最高也可以到 20tps ,干点小活也可以;但是 32K 上下文真不够,随便改个程序就 OOM 了。

    我在想能不能把上下文放主存,是不是不可行,或者会慢的令人发指。

    再就是噪音散热,P40 250W 的跑到 100%,只有一个后来加的小涡扇直接起飞,温度 89 度。其实散热还是不行,1 分钟以上就会掉功率降速。家里不让用,记得上次投诉是把矿机放家里的时候。

    综上还是掏钱买社会化服务方便。
    moregun
        51
    moregun  
       20 days ago
    这个有点类似买云盘服务还是自己部署 NAS 。本地部署的可以无视审查,防止数据泄露。
    dushixiang
        52
    dushixiang  
       20 days ago
    再等 5 年绝对有更适合部署 AI 的硬件,现在的显卡都是通用需求
    Need4more
        53
    Need4more  
    OP
       20 days ago
    @HENQIGUAI 没说 mac 没用啊,如果你买 mac 的理由是部署大模型省 token 费,那就没用。而且,你确定 96G 能有体感吗?
    CS50
        54
    CS50  
       20 days ago
    API 没有 Uncensored 模型给你用
    Rorysky
        55
    Rorysky  
       20 days ago
    @kevan 云厂商要赚钱呀 哥
    Serefrefee
        56
    Serefrefee  
       20 days ago
    我非常惊讶从头看到尾只有楼上一个人提到了 Uncensored
    这里的人既然都这么规矩为何还会翻出来?
    我本地部署只有一个原因 就是公网上的大模型都是审查版本 我想让 AI 教我些特别的东西公网版本的教不了
    yshan
        57
    yshan  
       20 days ago
    自部署一个是隐私,还有就是可以部署 无限制版本,机器折腾玩够了出手说不定还能赚
    Tink
        58
    Tink  
       20 days ago
    厂商也在买 mac 啊,我不知道你们在哪看到说没有厂商买 mac 做算力的。

    OpenAI 已购买数万台 Mac 用于强化学习训练,Anthropic 则采用租赁方式使用 Mac。两家公司都将苹果电脑纳入 AI 研发流程。报道指出,英伟达已将苹果视为本地 AI 领域的头号竞争对手,原因是 Mac 在 AI 开发者群体中正获得越来越高的关注度。苹果官方数据显示,2026 财年第三季度 Mac 营收同比增长 29%,为各产品类别中增速最快。
    Need4more
        59
    Need4more  
    OP
       20 days ago
    @Tink 别误导大家,这些厂商采购 mac 不是用来做推理的,是用来测试 Computer-Use Agents 。
    tealerK
        60
    tealerK  
       20 days ago
    谁自部署模型是为了便宜自部署的?经典自己立靶子自己打
    Tink
        61
    Tink  
       20 days ago
    @Need4more #59 是做强化学习的啊
    strobber16
        62
    strobber16  
       20 days ago via Android
    qwen 3.8 27b aa 52 分=dsv4 flash 0731 = luna max
    chjqpmain
        63
    chjqpmain  
       20 days ago
    根据每个人不同的情况,不同的价值评判权重,
    本来就没有任何方案可以说是任何问题的绝对最佳方案,
    技术也没有一个可以全方位都碾压的好方案,总能挑出毛病了,这样也才可以进步,一旦什么东西说不能再进步了,已经完美了,那么就都是后续的打脸, 类似物理界曾经的大厦已经建成,两朵乌云 那些时候的话,
    爱因斯坦的话也动不动,经证实,祂又又又错了,或者祂曾经被认为错误的,又又又对了...

    毕竟 有之以为利,无之以为用, 祂的好处恰恰是祂的坏处,祂的坏处恰恰是祂好处的来源.


    一般一切评判观点都是说这句话的人,以祂当时的信息以及认识 才是可以相对合理的.
    我这里一般不说这种绝对的词,非要说,也说什么流氓论证之类的,才这样提出来, 有的人喜欢说自己说个暴论,有些类似.

    可能是个人习惯和性格吧, 或者就是为了对立的流量和利益,不然我是不知道为什么一个人要发表争议言论,然后对线,可能祂选择用这个方式来打发时间吧
    Need4more
        64
    Need4more  
    OP
       20 days ago
    @chjqpmain 前面说的很有水平,可是最后开始揣测我的动机了和乱扣帽子了,我不太理解。任何观点是用来碰撞的,如果你要知道我的目的,那就是是为了听听还有什么不同的视角,不是为了说服任何人或者流量或者某些邪恶的目的。你作为看客如果觉得有启发,就没算我花费时间发这个帖子和做这些图表。

    当然,你觉得是胡扯,那直接喷我我也欢迎。
    sagnitude
        65
    sagnitude  
       20 days ago
    @Tink 是用来训练 Agent 如何使用鼠标、如何调用系统功能,不是用来训练模型本身,不是用来做算力,他唯一的价值就是:提供 MacOS 环境
    chjqpmain
        66
    chjqpmain  
       20 days ago via Android
    @Need4more
    你的标题和论点是 xxx 不是最佳方案,
    然后你内容里给出了你的情境和你的加权以及你这里的结论,

    我应该主观上没点你,可能给你带来误解了,

    我只是对 xxx 是绝对值 xxx 这种分享看法,

    我觉得治大国如烹小鲜,
    很多形而上学的道理是可以应用在具体情境里,
    从而分享的

    我要是要和你讨论,会引用你正文里的内容,然后提我的看法的,
    可是其实说到底就那点事,帖子已有的评论不都说遍了,就那几个角度,

    我就提了我的形而上学方面的分享
    Chicagoake
        67
    Chicagoake  
       20 days ago
    当然不是最优选择,但是“隐私”和“完全掌控在自己手里”就足矣让很多人选择自己部署了。网盘的性价比也远高于 NAS ,但是买 NAS 的很大一部分用户是不愿意把照片视频交给平台,交给审查。
    Morgan2
        68
    Morgan2  
       20 days ago
    @Chicagoake 飞牛用户:你说的对
    fe619742721
        69
    fe619742721  
       20 days ago   ❤️ 1
    @ahdw 这个类比我觉得不合理。
    买车相比打车,带来的好处是更方便、更灵活,这对出行来说是非常重要的因素,对绝大部分人适用。

    自部署相比于云端 api ,带来的好处是隐私性,但这个使用 ai 模型时的隐私性对绝大部分人没那么适用。

    这两个适用人群的差异就会导致这个类比失效。
    rillhu
        70
    rillhu  
       20 days ago
    @fe619742721 还不仅仅是这个。自己买车和打的车本质上性能差别不大。自己部署的模型生成质量和速度和使用厂商的比较而言,差别很大吧
    EthanDon
        71
    EthanDon  
       20 days ago
    @chjqpmain 咱能不能戏别这么多
    楼主明显考虑就是是工作之类的场景,没考虑隐私场景,你直接说出来就好了,屁大点的事佶屈聱牙半天,显得你有学问了
    chjqpmain
        72
    chjqpmain  
       20 days ago
    OP 这又不是提问,是发帖不就是每个人说话的吗? 隐私场景被说了很多楼了,我觉得没必要我再做一次复读机,而说了我想分享的,
    如果让你觉得我在显摆,那很抱歉,我并没有打算显摆,我只是一个碳基生物分享了自己的拙见罢了.
    我向来秉持的是,我知道我不知道,我最后选一个我当前知道的,这才可能不断的逼近追求的知道,我永远是有主观倾向的,所以我多数时候都加"我"这些限定词,承认每个人有各自的理解和环境,我自己绝对不可能是客观正确的,
    所以我互联网发内容会偏多一些,毕竟哪怕不可能绝对严谨,我也希望当时写时能相对严谨.


    如果你不喜欢长文,或者仅仅我的长文,那你不看即可,

    不过如果你认为我这是明显的戏多,那你愿意回复戏多,甚至教我你的经验,那我就这个动作本身表达感谢,
    如果你是向其他人分享或者提醒我这是戏多,那么你提醒一个很明显是戏多的话是戏多, 你这算不算戏多?

    以及你觉得我戏多,觉得我是高傲,自傲的,
    那你的表达方式就得体吗?

    反正我自己的有色眼镜让我觉得你这是爹味,高高在上的感觉,


    我的话让你不舒服,你可以 block 我,毕竟有句话是和聪明人对骂,也比和一些人调情有意思,话不投机半句多,
    不同频,那么后面再互相说什么都是孽缘,对对方的刻板印象只会不断加深,没啥意思,我不想不断重复"子非鱼,安知鱼之乐"的故事
    yjhatfdu2
        73
    yjhatfdu2  
       20 days ago
    当然我遇到一个有趣的点,我本地部署一些模型测试(因为客户有私有化需要),和云 API 对比,会发现云 API 有不会通知你的降智现象,表现为有些 agent 场景本地基本上稳定能完成,云端需要看时段,高峰时段可能就完不成
    Need4more
        74
    Need4more  
    OP
       20 days ago
    @EthanDon 我考虑隐私了也提及了,很多人不看内容直接发表意见,我表示很无语
    @chjqpmain 就事论事就行,揣测别人的动机不是个好习惯
    Need4more
        75
    Need4more  
    OP
       20 days ago
    @yjhatfdu2 你这当然也是一个选择本地部署的点,但就我说的这种场景,相比较于花费硬件投资的开销,这也是属于可以接受的,或者有其他方式解决
    chjqpmain
        76
    chjqpmain  
       20 days ago via Android
    @Need4more 我觉得揣测动机还是什么都是中性的,
    然后我个人感觉,说话的艺术就是
    会听话,会说话,听懂别人没表达的意思,说出的话能起到作用。

    而揣摩换个说法不也是领会,钻研吗?

    而且很多时候人好像不去揣摩,其实是已经揣摩过无数次了,因而直接已经穷举出来各种可能了,
    或者就是利益和影响不够重大,或者撞得墙,吃的亏不够多,或者单纯忘记了而已,

    我觉得多数时候只是大家不关注,或者心照不宣,而不是不存在

    那在这些比较自由的讨论中,我们都不敢提及和对讨论别人动机羞耻的话,
    那以小见大,
    我们碰到更大的压力,关系,利益时,又能表露多少实际的想法呢?

    很多时候现实只能虚与委蛇,
    可互联网某个观点探讨时,我是选择,我觉得不会造成什么恶劣影响,就该对事时该分析就分析,该探讨就探讨

    不然不让讲人性和人心,那也就没有书和书评可以存留于世了

    其他的无数领域的流程比如法律可以考虑人性人心,
    而别人哪怕被法律禁止讨论,心里就不想了吗?

    我是觉得堵不如疏

    比如我就选择考虑,思考过后,最后选择非要给出答案时,用论迹不论心这种奥卡姆剃刀后的结论,

    其他的每个人自己的态度和观念也应该在思考中得到

    我自然而然的有了新的感悟,新的认识,自然会得到新的我的处事时的依据,
    而不讨论,不思考,让自己活的很简单,
    很抱歉,
    我觉得和智慧果,认识,想法一样是潘多拉魔盒,打开了就回不去了,
    是礼物但也是诅咒
    niubilewodev
        77
    niubilewodev  
       20 days ago
    拿 API 价格来算本地 token 成本的。
    别忘了订阅的额度优惠,举个例子:200 美元的 GPT/Claude 订阅,能用 10000 美元的 API 额度。
    nyck
        78
    nyck  
       20 days ago
    @EthanDon 这大哥真的笑死了,每个帖子的评论区写长篇大论小作文
    nyck
        79
    nyck  
       20 days ago
    @Need4more 今天已经在几个帖子下面看到这个乐子人了,长篇大论写小作文加扣帽子,神了真的是
    Need4more
        80
    Need4more  
    OP
       20 days ago
    @chjqpmain 你可以说我发起的这个议题很没意思,评论区的观点没有新意,你经过思考后得出的结论是我在发表“暴论”,并且目的不纯。既然你喜欢讨论动机,那你的这些言论的动机是什么,展示你的深沉清醒,其他人都浅薄?

    你对别人提供了有用的信息吗?
    wilddog
        81
    wilddog  
       20 days ago
    @Need4more 他的动机是释放自己过剩的表达欲,顺便恶心别人
    chjqpmain
        82
    chjqpmain  
       19 days ago via Android
    @Need4more 我第 66 楼解释了,我没有评价你,
    我说的是, 完全只给一个绝对结论,然后别的什么都没提,然后看着评论区里站队等等的这种

    我 66 楼里明确说了,“你给了你的加权系数和评判,
    我没有点你的打算,可能让你误解了”

    而且我也说的是,我并不是正确的,
    我也说了帖子下不同的关于 mac 和不同设备跑本地模型的各种东西都够了,
    我就技术上,说的只是复读机了,所以我分享了别的看法,

    这是我核心表达的内容,
    然后你教我,不要过于揣测别人,
    我表达了我自己就揣测别人方面的主观想法,

    我没有说你的问题是否无聊,一个内容总有人,不同时期会想看的,

    你说了,你喜欢的是观点的碰撞,那你觉得我分享我就“揣测”的看法,就不是碰撞了?

    你说了,不要揣测别人,我说我认为揣测是个中性的,

    我没有攻击你以及任何人,
    我也只是发表关于仅仅一句绝对观点,然后这样无脑的讨论的看法,

    我 66 楼明确的解释了内容,

    于是说着不要揣测别人的你,揣测了我,
    这不是双标吗?

    那么我的表达能力有所欠缺,我的文字里论证的证据或许不足,

    可你的实际行动很好的弥补了证明的空缺


    至于你认为我是装清醒,那我永远无法向你证明我到底是什么根子,

    我目前认为的我的根子,就是为了活着而活着,为了打发时间而打发时间,为了表达而表达,

    就是人类被规训的社交需求,我一部分在网上解决了而已,
    我没打算装什么高高在上,不食人间烟火,我说了我就是个普通的碳基生物

    我句句的限定词都希望表达我的言论主观的,大家批判看待即可,

    我要是不加,那么更多的人会认为我是暴论,然后跟帖,评论
    然后我在不断的解释,

    我不喜欢这样,所以我如果表达,我都会尽力在每次表述时表述的详细

    你还有其他老哥,觉得我是包装自己还是怎么样就怎么样吧,

    至少我没说我不揣测别人,

    我之前第一个评论时,完全没有针对你发表看法,

    现在我对你的看法是,加油,能够百分百不揣摩别人的人,

    这是最好的习惯
    chjqpmain
        83
    chjqpmain  
       19 days ago via Android
    @nyck 主观上我没有怎么扣帽子,
    帽子和标签我们如何区分?
    对事和对人你如何区分?

    所以我写的长只是希望通过加足限定词,来更精确的表达我的观点,
    且多了一些表示这是我的主观看法的内容。

    我主动在我的各个内容通过词藻多处互相印证的表达我的内容我的个人,性格,思想,经历的主观色彩,

    希望看了的大家批判看待,兼听则明,偏听则暗,尽信书不如无书,
    我也不是圣人,无法每个时刻每个内容都是正确的,
    而且也没有圣人,我认为圣人不死,大盗不止,我也不打算做圣人,

    而不喜欢看长文的朋友没缘分过掉了就过掉了,

    这些是我的态度和习惯,我不可能让每个人觉得如沐春风,我没那么强的表达功力
    chjqpmain
        84
    chjqpmain  
       19 days ago via Android
    @wilddog 你高兴就好,我哄你我帮你 block 我后,果然你就没在你的帖子回我了,我觉得这就挺好嘛

    你要是最开始和 2 楼老哥没那么语气,至于后面那样吗?

    既然我是影响你心情的,你贴子下很多都是恶心你的,

    那我还是觉得你多多 block 更保重你的心情和身体呢
    burn
        85
    burn  
       19 days ago
    有没有可能,128GB MacBook Pro 、ChatGPT 、Claude 订阅,我都买了。
    ahdw
        86
    ahdw  
       19 days ago
    @fe619742721

    我觉得就当前 2026 年 9 月来看,「绝大部分人」确实如你所说,在只关注本地部署带来的隐私性这一方面来看,这个类比不恰当。

    ---

    但我有新的论据。

    90 年代的私家车,相比打车,更方便、更灵活的优势依然存在,但是当年的本土汽车市场可没有现在这么发达。这说明对「绝大多数人」而言,还有其他因素在。

    就汽车而言,这个因素是汽车单价相对于收入的比例。现在这个比例远不如 90 年代时那么悬殊了,因此「绝大多数人」开始正视这个需求,并迎来了私家车市场的空前繁荣。汽车技术进步也对降低这个比例有很大贡献。

    ---

    说回本地模型。隐私不是唯一的考量。
    除了本帖中讨论的众多因素之外,我还想补充以下几点:

    首先,随着模型技术的发展(既包括开源模型的能力提升、也包含小尺寸模型的相对智能越来越强、还包含推理引擎的迭代优化),在消费级硬件上可以部署能力足够强的模型了。这个趋势不会变。也就是说,本地部署模型不一定需要购买昂贵的新硬件。

    然后,模型的能力是主观的。
    第一个角度是,人类作为模型的使用者,是有自己的偏好的。当年 ChatGPT 下线 GPT-4 系列,全面用 GPT-5 来面向终端用户的时候,可是引起了巨大反感。
    第二个角度是,对模型能力的评估,就没有普适的客观标准。
    在有确定性的领域,比如编程,有很多 benchmark ,但是在实际使用当中,大家并没有一边倒地认为 benchmark 得分高的模型用起来就一定比得分低的模型强(可感知的强)。当然可以说这是所谓的 benchmaaxed 的结果,但这不影响结论:评价标准本身有问题。
    而被视为衡量各大模型真实使用体验的最直观标准之一,也就是 LMArena ,它采用的是盲测的形式(双盲对比):用户在平台上输入任意提示词( Prompt )后,系统会调用两个匿名的 AI 模型给出回答(例如 Model A 和 Model B )。用户在不知道模型身份的情况下,根据哪个回答更好进行投票,投完票后系统才会揭晓两个模型的真实名字。最后的排行也是动态的。平台通过收集数千万次真实用户的盲测投票,利用类似国际象棋的 Elo 评分系统( Bradley-Terry 模型)计算出各个模型的实时胜率和排名。
    这个标准本身反应的,恰恰是这种模型能力的「主观性」。比如从这个 LMArena 上能看人们相比于很多私有部署的大模型,反而更偏爱小尺寸的开源模型。

    最后,建立在前两条的基础上,可以得出结论,当你的需求,可以被某个本地中小尺寸模型满足时,而技术允许你把它部署在你已经拥有的设备上,或者你花少量金钱升级后的硬件设备上时,你一定会被吸引的。
    就像你上班不需要开法拉利一样,对「绝大多数人」来说,他们也不需要 GPT-5.6-sol-max 或者 Kimi K3.

    如果当年的 GPT-4 就能满足你的需求,那么我敢说,当你能在自己的硬件上拥有这个程度的智能时,你一定不会想要租赁。

    ---

    Callback 汽车的类比。在汽车领域,那个隐藏因素是「汽车单价相对于收入的比例」,在本地部署模型的领域,这个因素是「硬件购置与算力门槛相对于模型真实可用性的比例」,而这个「真实可用性」,是主观的。

    比如我就在 5 年前的硬件( M1 Max )上部署了若干中小尺寸的模型。它们满足了我很大一部分需求。2023 年、2024 年、2025 年我都曾经花过 20 美元订阅 GPT-Plus (那个时候 Codex ,或者说 Agentic Coding 还不是个流行概念),现在这部分需求我完全不用花钱了。

    我现在依然会为 Agentic Coding 花钱,这方面我愿意承担成本的硬件上可以部署的本地中小尺寸模型的「真实可用性」还没有越过那个临界点。

    ---

    一个证据:就聊天而言,无论是 Gemini ,还是 ChatGPT ,免费额度几乎都用不完了。当然,现今最先进的免费模型的体验(比如说 GPT-5.4 mini 之类)是否在主观上真的比当年的 GPT-4o 强,大家自己心里都有数。

    模型厂这方面的慷慨,恰恰说明了,这个领域的本地模型的「真实可用性」已经足够高了。

    ---

    最后,我再强调一下,就当前 2026 年 9 月来看,「绝大部分人」确实如你所说,在只关注本地部署带来的隐私性这一方面来看,这个汽车类比不恰当。
    但是,当「绝大多数人」可以承担得起的硬件上,能够部署的本地模型,相对于他们的需求的「真实可用性」超过临界值时,考虑本地部署就会变成理所当然的事情。

    有兴趣可以看看我写的这两篇知乎专栏文章:
    https://zhuanlan.zhihu.com/p/2063768272701592014
    https://zhuanlan.zhihu.com/p/2063060063984654083
    back0893
        87
    back0893  
       19 days ago
    个人部署的 27b 应该甜点级别 足够使用
    Rehtt
        88
    Rehtt  
       19 days ago
    自部署优势是隐私、私有化定制。比如跑一些去除安全限制的模型
    winson030
        89
    winson030  
       19 days ago
    @back0893 需要一个 5090 服务器!足够了
    lesismal
        90
    lesismal  
       13 days ago
    @isbase #48 这个问题我不专业,我不乱回复
    About   ·   Help   ·   Advertise   ·   Blog   ·   API   ·   FAQ   ·   Privacy   ·   Solana   ·   3203 Online   Highest 6679   ·     Select Language
    创意工作者们的社区
    World is powered by solitude
    VERSION: 3.9.8.5 · 152ms · UTC 12:30 · PVG 20:30 · LAX 05:30 · JFK 08:30
    ♥ Do have faith in what you're doing.